Banyak orang pernah mengalaminya. Anda meminta AI menulis satu fungsi, dan hasilnya benar. Lalu Anda meminta AI membangun seluruh aplikasi, dan hasilnya penuh kesalahan yang sulit dilacak.
Gejala ini bukan kebetulan. Dalam riset, pola tersebut dikenal sebagai kegagalan long-horizon. Artikel ini memakai istilah long horizon planning collapse. Maksudnya, kualitas AI turun ketika tugas terdiri dari banyak langkah yang saling bergantung.
Apa Itu Long Horizon Planning Collapse?
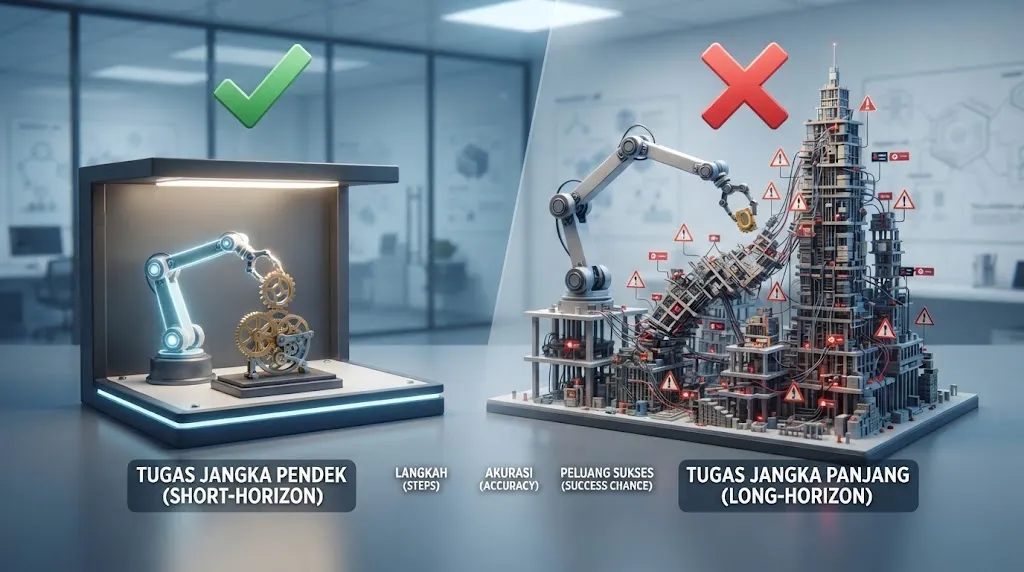
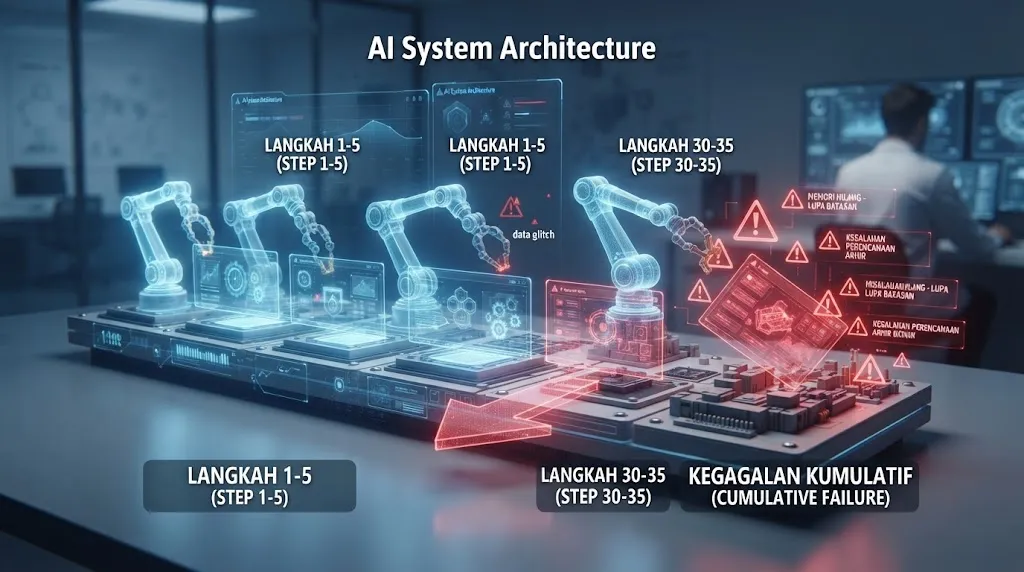
Horizon di sini berarti jumlah langkah yang harus selesai sebelum tujuan tercapai. Tugas short-horizon hanya butuh satu atau dua langkah. Tugas long-horizon butuh puluhan langkah, dan setiap langkah memakai hasil langkah sebelumnya.
Jadi masalahnya bukan pada kemampuan AI di satu langkah. Masalahnya ada pada rangkaian. Satu kesalahan kecil di awal ikut terbawa ke langkah-langkah berikutnya, dan AI jarang menyadarinya.
Studi berjudul The Long-Horizon Task Mirage menyebut hal serupa. Para penulisnya menjelaskan bahwa kesalahan kecil per langkah menumpuk pada langkah yang saling bergantung. Akibatnya, kegagalan muncul berantai, bukan sekaligus di awal.
Hitungan Sederhana di Balik Penurunan Akurasi
Cara termudah memahami masalah ini adalah dengan rumus peluang. Jika setiap langkah benar dengan peluang p, dan ada n langkah berurutan, peluang seluruh tugas benar adalah p pangkat n.
Contohnya, akurasi 95% per langkah terdengar sangat baik. Namun setelah 20 langkah, peluang seluruh tugas benar hanya sekitar 36%. Setelah 50 langkah, tinggal sekitar 8%.
Tabel berikut menunjukkan peluang sukses untuk beberapa tingkat akurasi per langkah. Angkanya hasil hitungan p pangkat n, bukan hasil pengujian model tertentu.
| Jumlah langkah | 90% per langkah | 95% per langkah | 97% per langkah | 99% per langkah |
|---|---|---|---|---|
| 5 | 59,0% | 77,4% | 85,9% | 95,1% |
| 10 | 34,9% | 59,9% | 73,7% | 90,4% |
| 20 | 12,2% | 35,8% | 54,4% | 81,8% |
| 40 | 1,5% | 12,9% | 29,6% | 66,9% |
| 50 | 0,5% | 7,7% | 21,8% | 60,5% |
Perhatikan kolom 97%. Pada 40 langkah, peluang suksesnya sekitar 30%. Pola inilah yang sering dibicarakan: akurat di satu fitur, tetapi jauh lebih rendah di satu proyek penuh.
Perbaikan kecil juga tidak banyak menolong. Menurut analisis Tian Pan, naik dari 90% ke 95% per langkah hanya menaikkan peluang tugas 10 langkah. Angkanya bergeser dari 35% ke 60%.
Asumsi Hitungan Ini Terlalu Rapi
Rumus tadi mengandaikan setiap kesalahan berdiri sendiri. Kenyataannya lebih rumit. Survei The Horizon Gap menyebut model itu sebagai pembanding yang berguna, bukan hukum yang terbukti.
Survei yang sama mencatat bahwa kegagalan cenderung mengumpul di tahap tertentu. Hasil akhirnya pun sering terbelah: berjalan baik, atau keluar jalur sama sekali.
Artinya, penurunan akurasi tidak selalu mulus. Agen bisa tampak normal selama belasan langkah, lalu tiba-tiba melenceng. Kapan itu terjadi belum bisa diprediksi dengan andal.
Jenis Kesalahan Ikut Berubah pada Tugas Panjang
Studi Long-Horizon Task Mirage menguji agen pada lebih dari 700 tugas di empat domain. Temuannya, komposisi kesalahan ikut bergeser. Pada tugas panjang, kesalahan perencanaan dan kesalahan memori menjadi yang dominan.
Sebagai gambaran, ada 1.145 percobaan GPT-4o-mini yang gagal dalam studi itu. Sebanyak 64,9% di antaranya disebabkan kesalahan perencanaan, dan 18,3% oleh keterbatasan memori. Ada tiga mekanisme yang menjelaskan hal ini.
Instruksi Awal Terlupakan
Instruksi awal diuraikan ulang menjadi banyak langkah kecil. Semakin panjang prosesnya, semakin besar risiko batasan yang halus melemah atau hilang. Misalnya, aturan “jangan ubah bagian ini” tidak lagi diingat di langkah ke-30.
Kesalahan Tidak Langsung Terlihat
Pada tugas pendek, kesalahan langsung tampak. Pada tugas panjang, asumsi yang salah bisa bertahan selama dua puluh langkah tanpa disadari. Saat akhirnya muncul, agen sudah membangun banyak pekerjaan di atasnya.
Tidak Ada Jalur Pemulihan
Makalah tersebut mencatat bahwa tanpa validasi aksi, rollback, dan koreksi berbasis umpan balik, kesalahan kecil membesar. Glitch yang awalnya terisolasi berubah menjadi kegagalan yang menghentikan seluruh proses.
Bukti dari Benchmark
Beberapa angka dari sumber yang dirujuk memperlihatkan jaraknya:
- Menurut ringkasan sebuah makalah tentang agen multi-turn, GPT-4o hanya mencapai 30,2% di benchmark AppWorld. Llama3-70B mencapai 7,0%.
- Ringkasan yang sama menyebut model 8B dengan akurasi langkah 60% bisa mendekati nol keberhasilan pada horizon panjang.
- Analisis Tian Pan mencatat model terdepan hanya berhasil 15–24% pada tugas yang mengubah banyak file. Padahal subtugas tunggalnya dikerjakan dengan baik.
Angka-angka ini berasal dari benchmark dan ringkasan pihak ketiga. Hasilnya bisa berbeda untuk model dan tugas lain, jadi anggap sebagai gambaran pola, bukan patokan pasti.
Apa Artinya bagi Pengguna AI
Hasil bagus pada satu langkah tidak bisa dijadikan jaminan untuk seluruh proses. Uji coba kecil memang berguna, tetapi tidak mewakili proyek utuh.
Saat memberi AI tugas panjang, anggap setiap langkah sebagai titik yang perlu diperiksa. Pendekatan seperti memecah tugas, memvalidasi hasil antar-langkah, dan menyiapkan jalur pemulihan membantu menekan penumpukan kesalahan.
Pelajari Selengkapnya di buku Stay Human Stay In Charge – Transformasi AI di Korporasi yang bisa didapatkan di http://asosiasi.ai/store
Referensi
- https://arxiv.org/abs/2604.11978
- https://arxiv.org/pdf/2608.06663
- https://tianpan.co/blog/2026/04/20/compound-accuracy-multi-step-agent-pipelines
- https://tianpan.co/blog/2026-04-16-the-delegation-cliff-agent-reliability
- https://co-r-e.com/method/lumina-multi-turn-agents
- https://sellscale.com/blog-posts/introduction-to-long-horizon-agents/
- https://www.buildmvpfast.com/blog/why-long-horizon-ai-agents-fail-compounding-error-memory-2026